Le surdimensionnement est la norme
Le calcul, les bases de données et les requêtes Kubernetes sont dimensionnés pour un pic qui survient rarement, puis ne sont jamais réévalués. Chaque nouvelle charge de travail démarre surdimensionnée et le reste.
Produit · Optimisation cloud
L'Agent Analyseur scanne en continu le calcul, les bases de données et le stockage sur chaque compte connecté, et transforme ce qu'il trouve en une action classée et chiffrée en dollars, livrée sous forme de diff Terraform prêt pour une PR ou d'un guide ClickOps étape par étape.
Redimensionnement et Spot Cycle de vie du stockage Nettoyage des ressources inactives et hors production
Pourquoi les économies ne tiennent pas
Le surdimensionnement n'est pas une erreur ponctuelle. C'est l'état par défaut d'un parc cloud en croissance. Sans surveillance continue, il finit toujours par revenir.
Le calcul, les bases de données et les requêtes Kubernetes sont dimensionnés pour un pic qui survient rarement, puis ne sont jamais réévalués. Chaque nouvelle charge de travail démarre surdimensionnée et le reste.
Environnements de développement actifs le week-end, stockage non rattaché, points de terminaison oubliés : invisibles jusqu'à ce que quelqu'un aille les chercher, et ce n'est le travail de personne de les chercher.
Un nettoyage ponctuel remet le compteur à zéro, mais les nouvelles charges de travail démarrent surdimensionnées et les valeurs par défaut régressent. Sans surveillance continue, les dépenses dérivent à nouveau en moins d'un an.
Ce qui est détecté
L'Agent Analyseur scanne en continu le calcul, les bases de données et le stockage sur chaque compte connecté, et transforme ce qu'il trouve en une action classée, pas seulement un graphique.
Chaque ressource reçoit une action recommandée concrète : redimensionner, migrer vers Graviton, passer sur Spot, réduire l'échelle ou supprimer, chacune assortie d'une estimation d'économies en dollars, de sorte que la priorisation devient un simple tri, pas une supposition.
Chaque recommandation avance dans un pipeline de statuts : Découvert, En cours, Terminé, afin que votre équipe voie ce qui a été traité par rapport à ce qui reste ouvert, au lieu de perdre les constats dans un tableur.
Chaque recommandation précise l'effort d'implémentation, si un redémarrage est requis, si l'action est réversible sans risque, les identifiants exacts des ressources concernées, et les preuves à l'appui : le niveau de détail dont un ingénieur a réellement besoin avant de toucher à la production.
Les recommandations sont rédigées en langage naturel : pourquoi une migration de base de données fait économiser de l'argent, les caractéristiques actuelles par rapport à celles visées, la marge de capacité restante, pas seulement un déversement brut de métriques.
Deux de ces recommandations, de bout en bout :
Preuves d'économies
des dépenses totales perdues à la dérive d'ici le 12e mois sans optimisation continue
récupérés en continu sur une facture cloud de 100 000 $/mois
risque à la baisse : si les économies vérifiées n'atteignent pas nos frais, nous créditons la différence
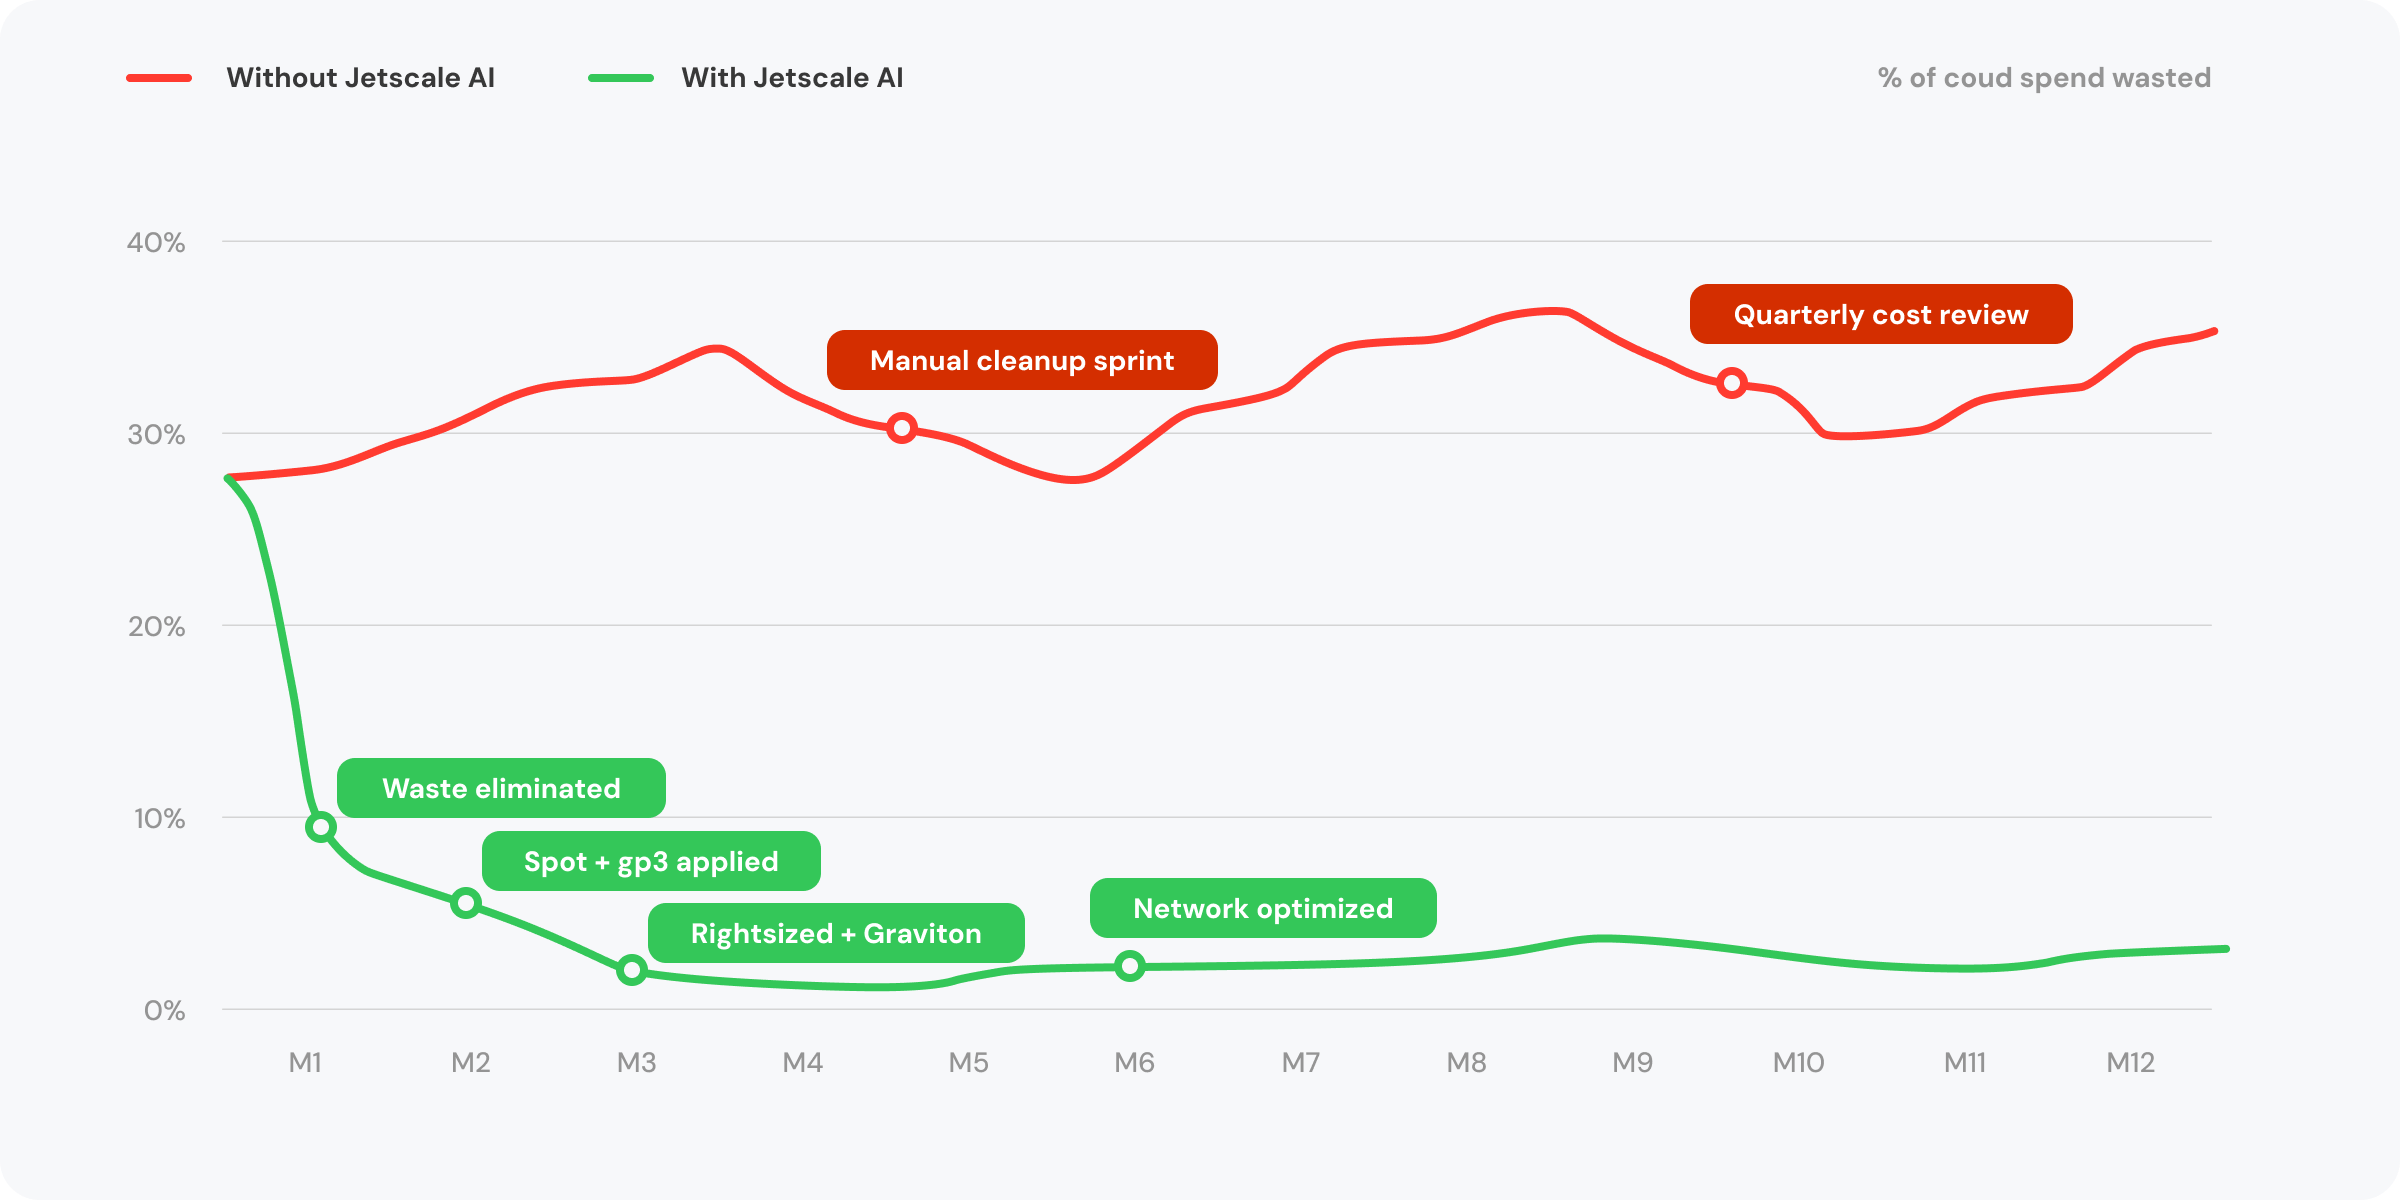
Chiffres de dérive tirés du modèle de dérive cumulative de Jetscale. Voir Pourquoi Jetscale pour le détail.
En savoir plus sur la plateforme
Pour commencer
Connexion en lecture seule. Constats étayés par des preuves. Correctifs prêts pour une PR. Autofinancé, avec un ROI garanti.